 Salta al contenuto


Information gain: cos’è e come funziona nella SEO e nella GEO
Nella SEO e nella GEO, l’information gain, o guadagno informativo, indica quanto una pagina riesca a far progredire la comprensione di un tema rispetto a ciò che la persona ha già letto, ascoltato o ricevuto durante la ricerca.
Cosa significa information gain nella SEO
Il termine descrive una qualità relativa e contestuale. Pensiamo a un mosaico: una tessera è preziosa quando completa il punto rimasto vuoto; sopra un’immagine già compiuta serve molto meno. Allo stesso modo, il valore di una pagina dipende dall’argomento, dalla domanda, dal lettore e dal tratto di percorso informativo già compiuto.
Nella teoria dell’informazione e nel machine learning, l’espressione indica quanto un dato riduca l’incertezza.
Nel lessico SEO resta l’idea del passo avanti ma cambia il termine di confronto.
La stessa pagina può orientare chi affronta il tema per la prima volta e risultare già familiare a chi ha consultato fonti più approfondite: molto dipende dal punto del percorso e quindi di consapevolezza in cui ciascuno si trova.
Information gain, rilevanza e content gap: le differenze
La rilevanza è la porta d’ingresso: una pagina deve corrispondere alla query e al suo intento di ricerca. Una volta entrati nella stanza giusta, conta quanto la lettura faccia avanzare il percorso. Così, un articolo può rispondere perfettamente alla domanda e sembrare comunque il quinto riassunto della stessa spiegazione.
Il content gap è invece uno scaffale vuoto nel corpus scelto, cioè nell’insieme di contenuti osservato: segnala un aspetto assente o appena accennato. La sua utilità dipende ancora dall’intento. Anche l’originalità formale vive su un altro piano: una riscrittura brillante può cambiare abito alle stesse idee; una scoperta importante può essere raccontata con parole semplicissime.
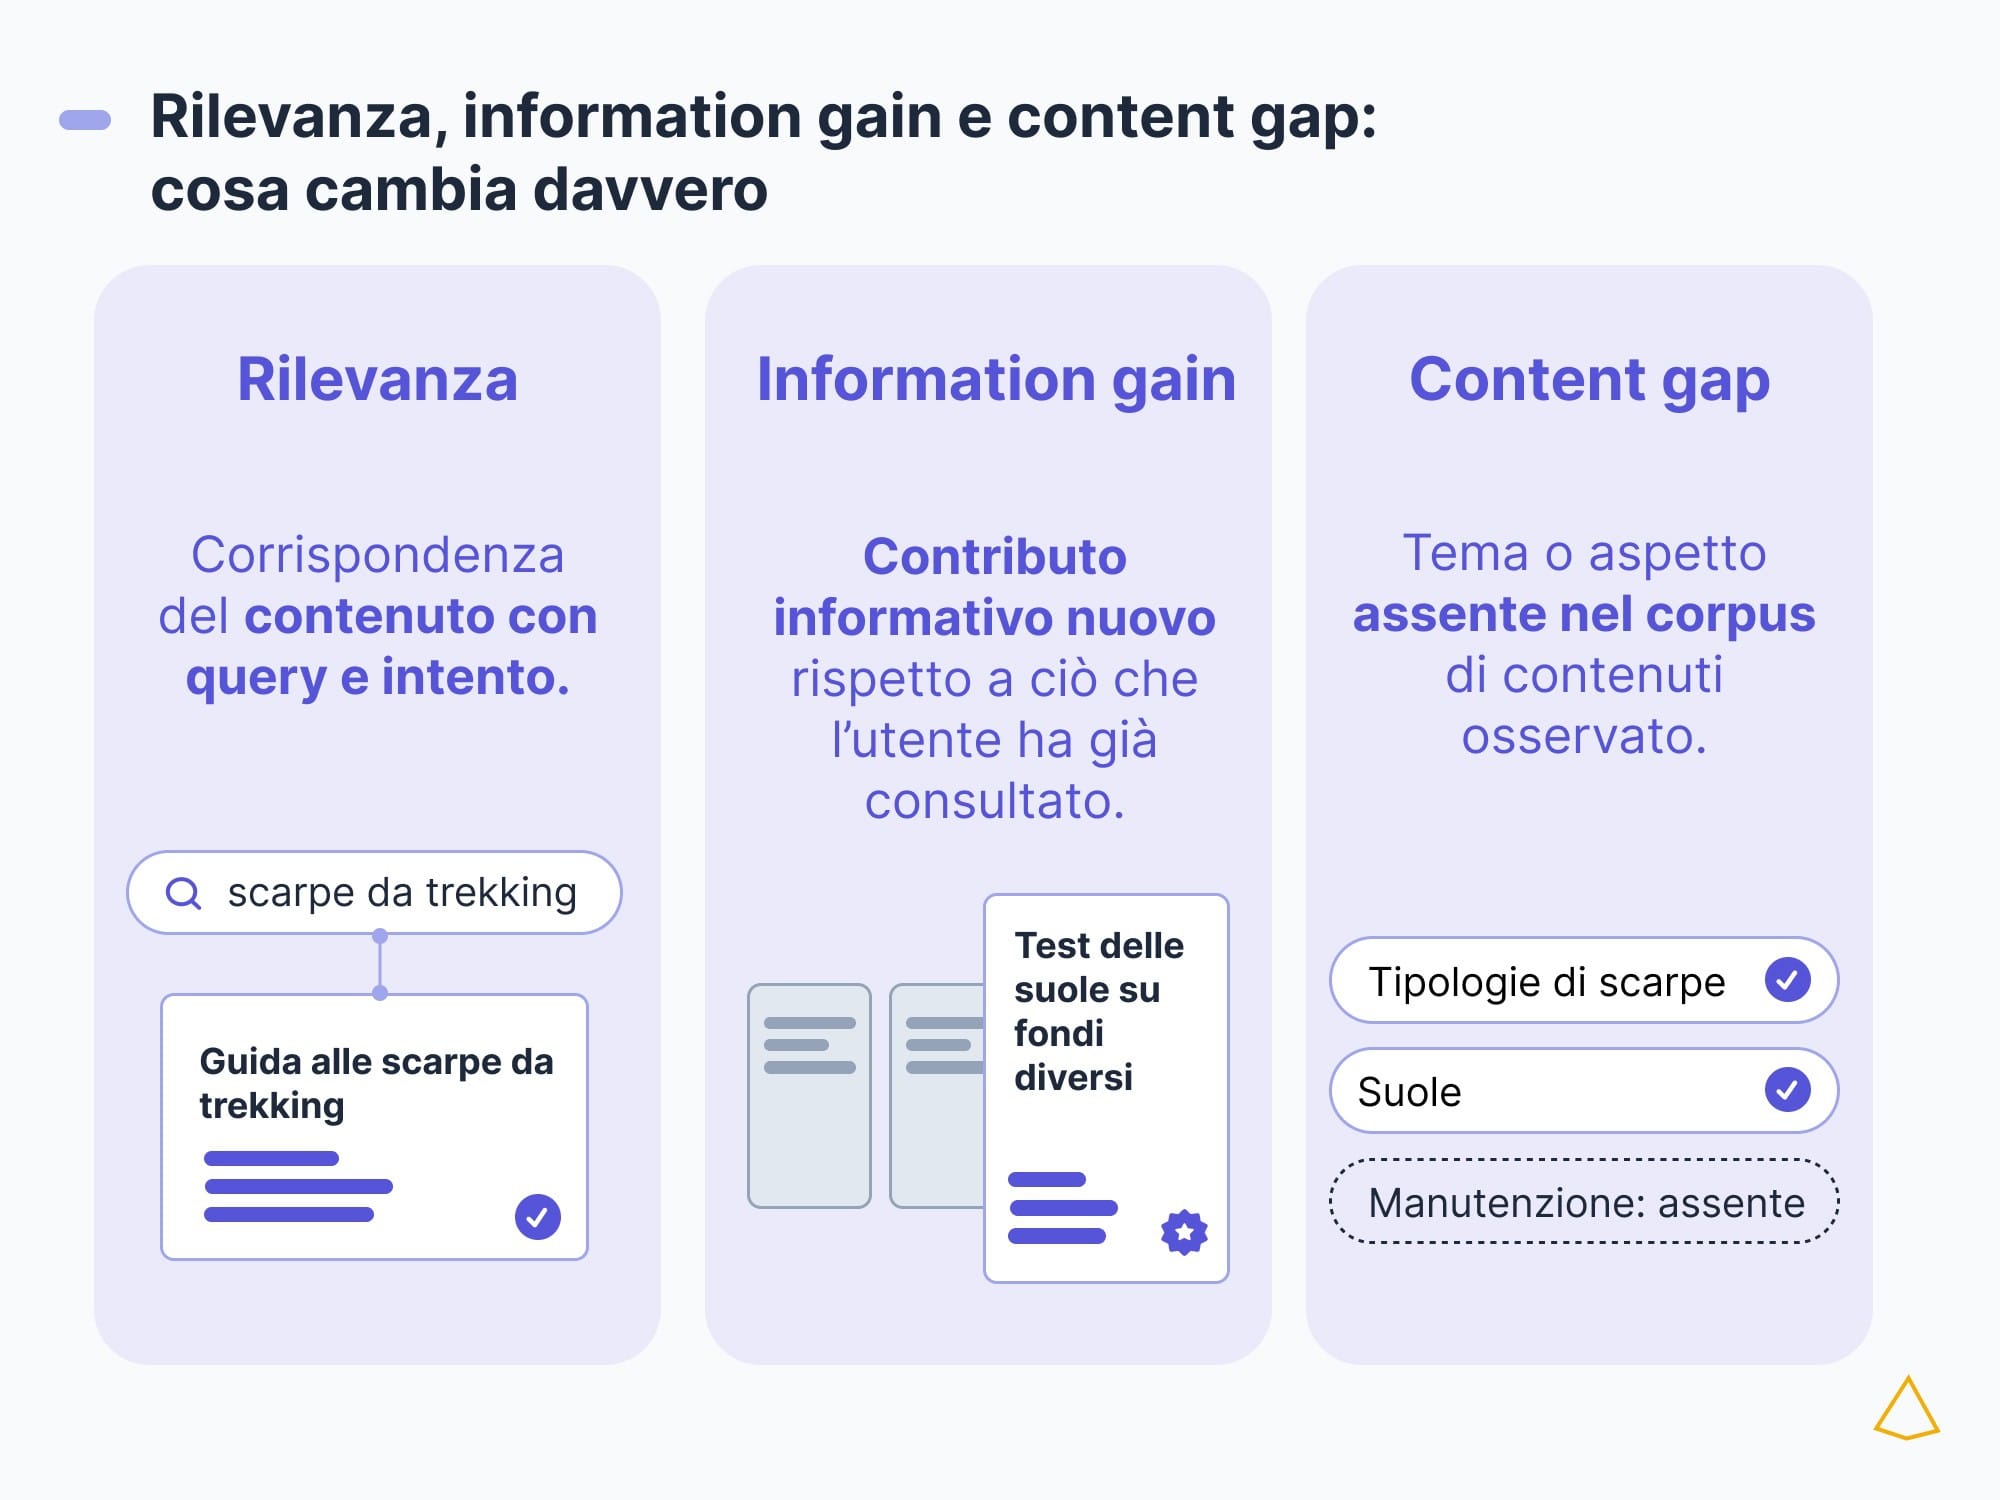
Grafica comparativa tra rilevanza, information gain e content gap
Come funziona l’information gain nel brevetto di Google
La storia della famiglia brevettuale Google comincia il 18 ottobre 2018, data di priorità e deposito internazionale. Negli Stati Uniti, la domanda fu pubblicata il 5 novembre 2020 come US20200349181A1; il brevetto venne concesso il 7 giugno 2022 con il numero US11354342B2.
Le lettere finali raccontano il passaggio: A1 identifica qui la domanda pubblicata, B2 il brevetto concesso. Le successive continuazioni della stessa famiglia hanno prodotto US11720613B2, US12013887B2 e US12326889B2, concessi tra il 2023 e il 2025. Per questo fonti diverse possono citare numeri differenti riferendosi allo stesso filone brevettuale.
I documenti già presentati all’utente
Sul monitor possono comparire dieci risultati. L’utente ne apre uno; un assistente può leggergli una sintesi tratta da un altro.
Nel brevetto, il primo insieme può comprendere i documenti già aperti dall’utente oppure quelli dai quali il sistema ha estratto e presentato informazioni. La persona può aver visto una pagina intera, un passaggio o una sintesi; può anche averne ascoltato una parte. Il confronto parte dalle informazioni effettivamente consultate o presentate; gli altri risultati della SERP restano tra le risorse da esplorare.
I documenti non ancora visti e l’information gain score
Il secondo insieme comprende le risorse sullo stesso tema ancora da esplorare.
Il sistema prova a stabilire quale potrebbe essere più utile come passo successivo, tenendo conto del materiale già passato davanti agli occhi o alle orecchie dell’utente.
Il confronto può usare il testo, i passaggi estratti o rappresentazioni numeriche.
Gli embedding, ossia vettori che collocano significati simili in zone vicine, funzionano come coordinate su una mappa; il bag-of-words conta invece parole e frequenze, ignorandone l’ordine.
Le valutazioni di curatori o utenti possono infine diventare etichette di addestramento, ovvero esempi di risorse più informative o più ripetitive dai quali il modello apprende.
Il riordinamento dei risultati e gli assistenti conversazionali
Immaginiamo un itinerario che si aggiorna dopo ogni tappa. Quando una nuova informazione viene presentata, il sistema la inserisce nel percorso, ricalcola l’utilità attesa delle risorse rimaste e può cambiarne l’ordine. Questo nuovo ordinamento prende il nome di reranking.
Il brevetto contempla anche assistenti automatici e risposte vocali. Una pagina si esplora rapidamente con lo sguardo; una voce procede in fila, parola dopo parola.
Ogni ripetizione occupa tempo; una sequenza ben selezionata rende il dialogo più breve e conduce prima all’informazione utile.
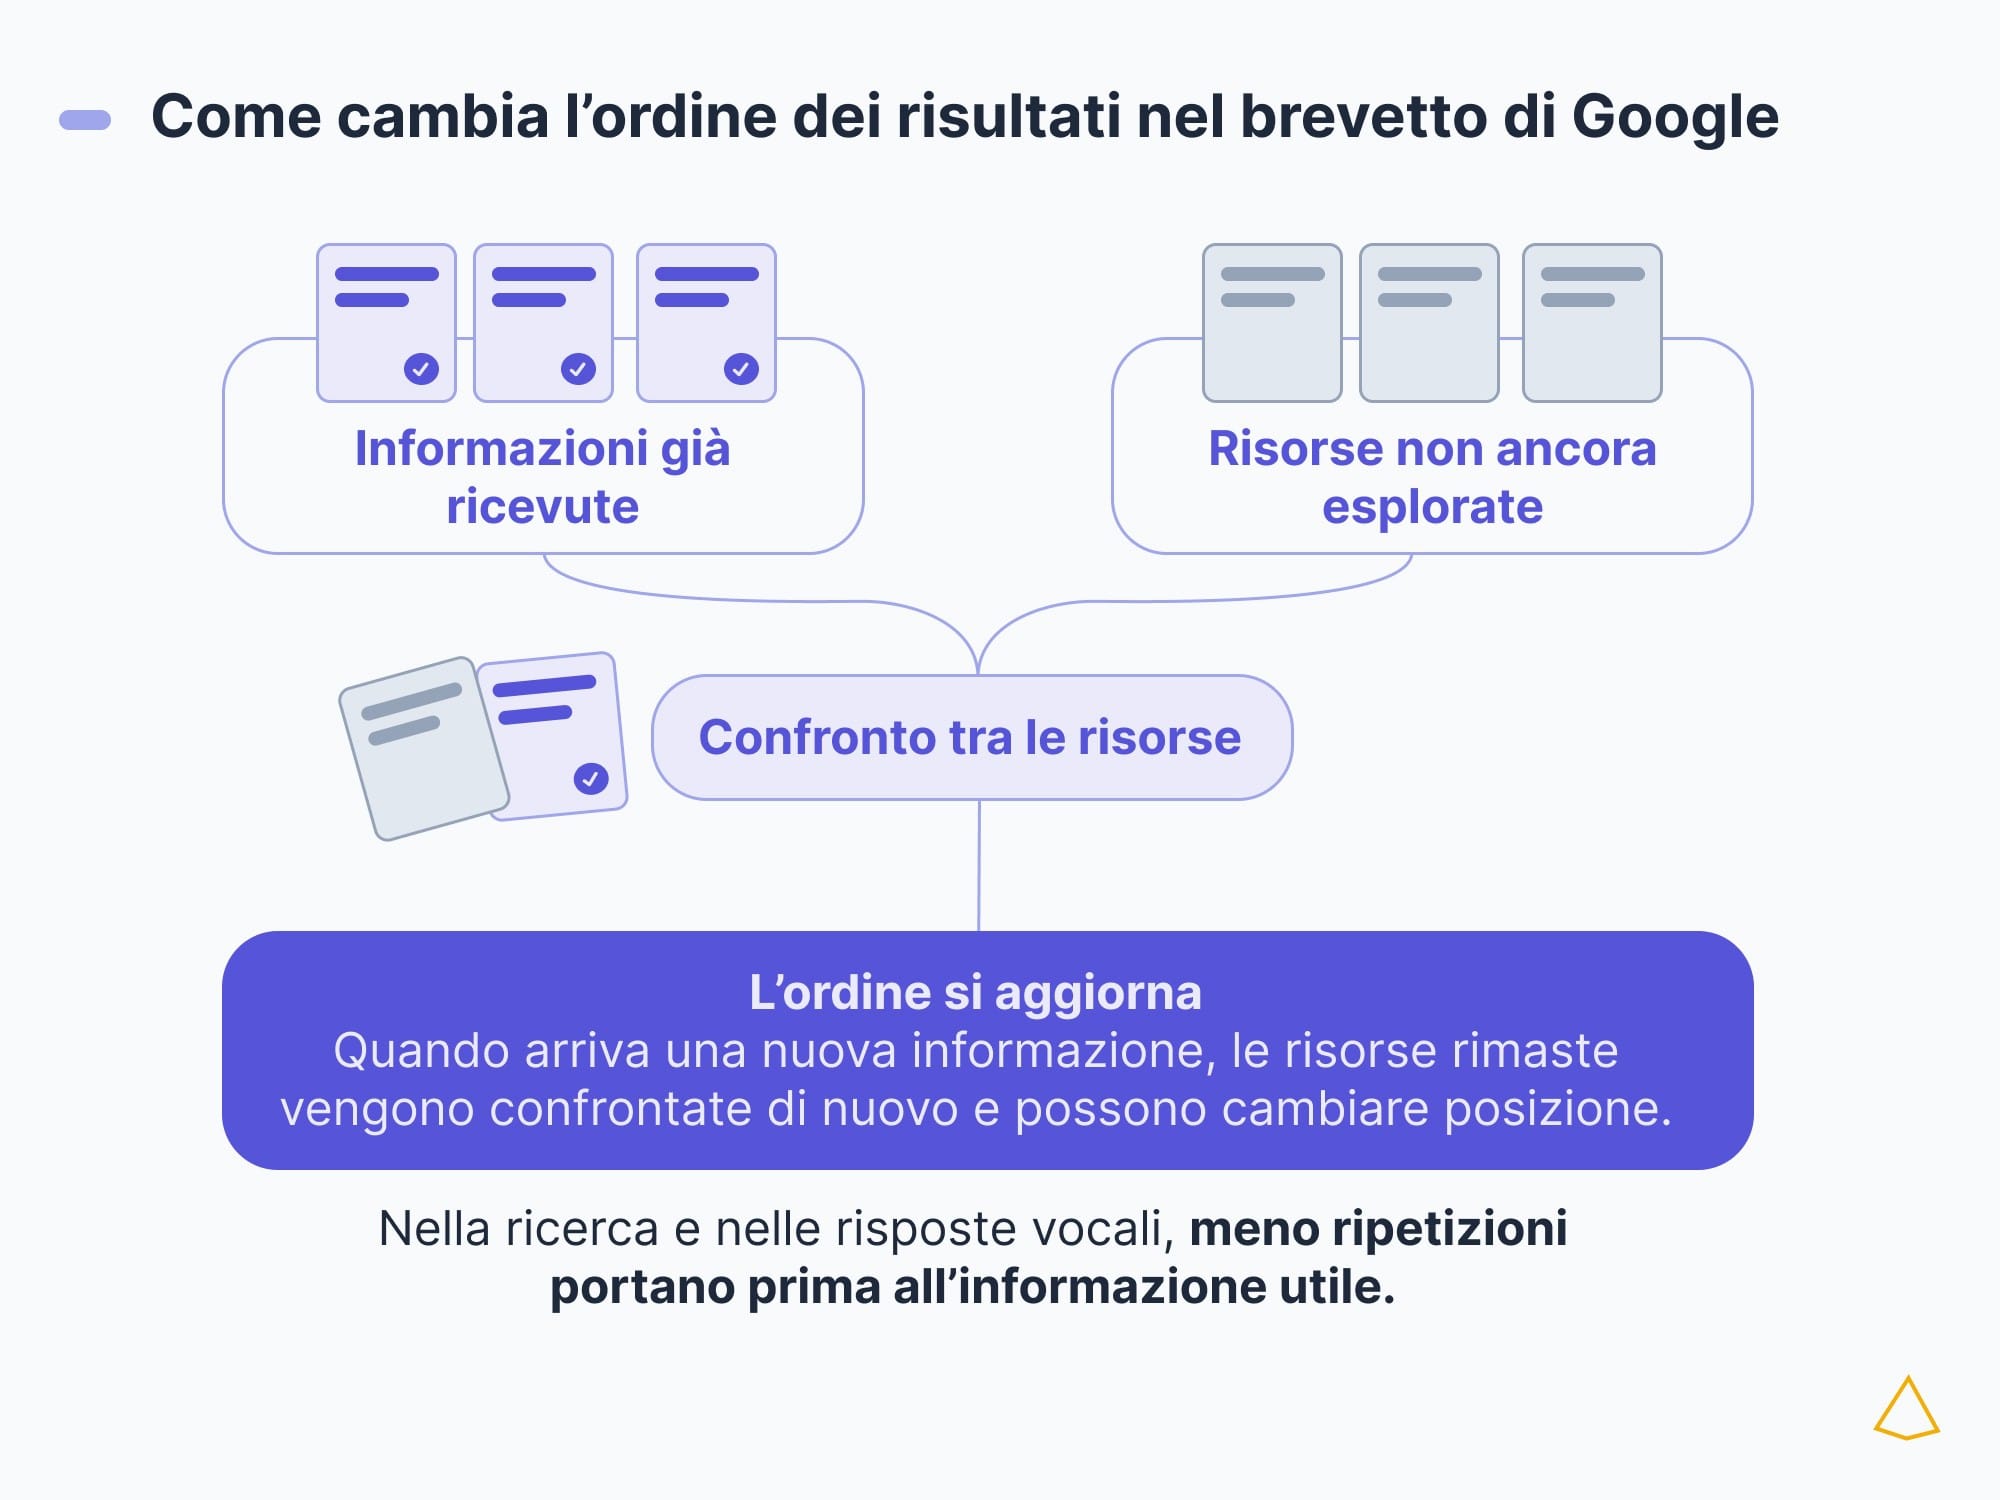
Ogni nuova informazione riordina le risorse ancora da valutare
L’information gain è un fattore di ranking di Google?
Google non ha confermato l’information gain score come fattore di ranking autonomo o sistema attivo nella Ricerca.
Un brevetto descrive un possibile motore; la prova del suo impiego richiede conferme separate.
La guida ai sistemi di ranking presenta soltanto alcuni dei sistemi più rilevanti e non ne elenca uno con questo nome.
Le indicazioni editoriali sono invece esplicite. Google invita a pubblicare informazioni originali, ricerca e analisi e, nella guida aggiornata il 10 luglio 2026, raccomanda contenuti utili, affidabili e non-commodity, capaci di andare oltre le conoscenze comuni. Questi principi descrivono la qualità desiderata; il brevetto documenta una soluzione tecnica distinta.
Lo studio di On-Page.ai ha esaminato 150 pagine: i primi tre risultati organici di 50 ricerche in inglese, rilevati negli Stati Uniti il 12 giugno 2026. Il software ha confrontato il significato del testo principale di ogni pagina con quello delle altre risorse della stessa SERP e ha assegnato a ciascuna pagina un proprio punteggio da 0 a 100.
Le mediane delle posizioni 1, 2 e 3, rispettivamente 52, 51,5 e 52, erano quasi identiche.
È come misurare la statura dei tre corridori sul podio: quel dato, da solo, non spiega l’ordine d’arrivo. Gli autori presentano il risultato come una fotografia del campione, non come la ricostruzione di un segnale interno di Google o la prova che quel punteggio determini il ranking.
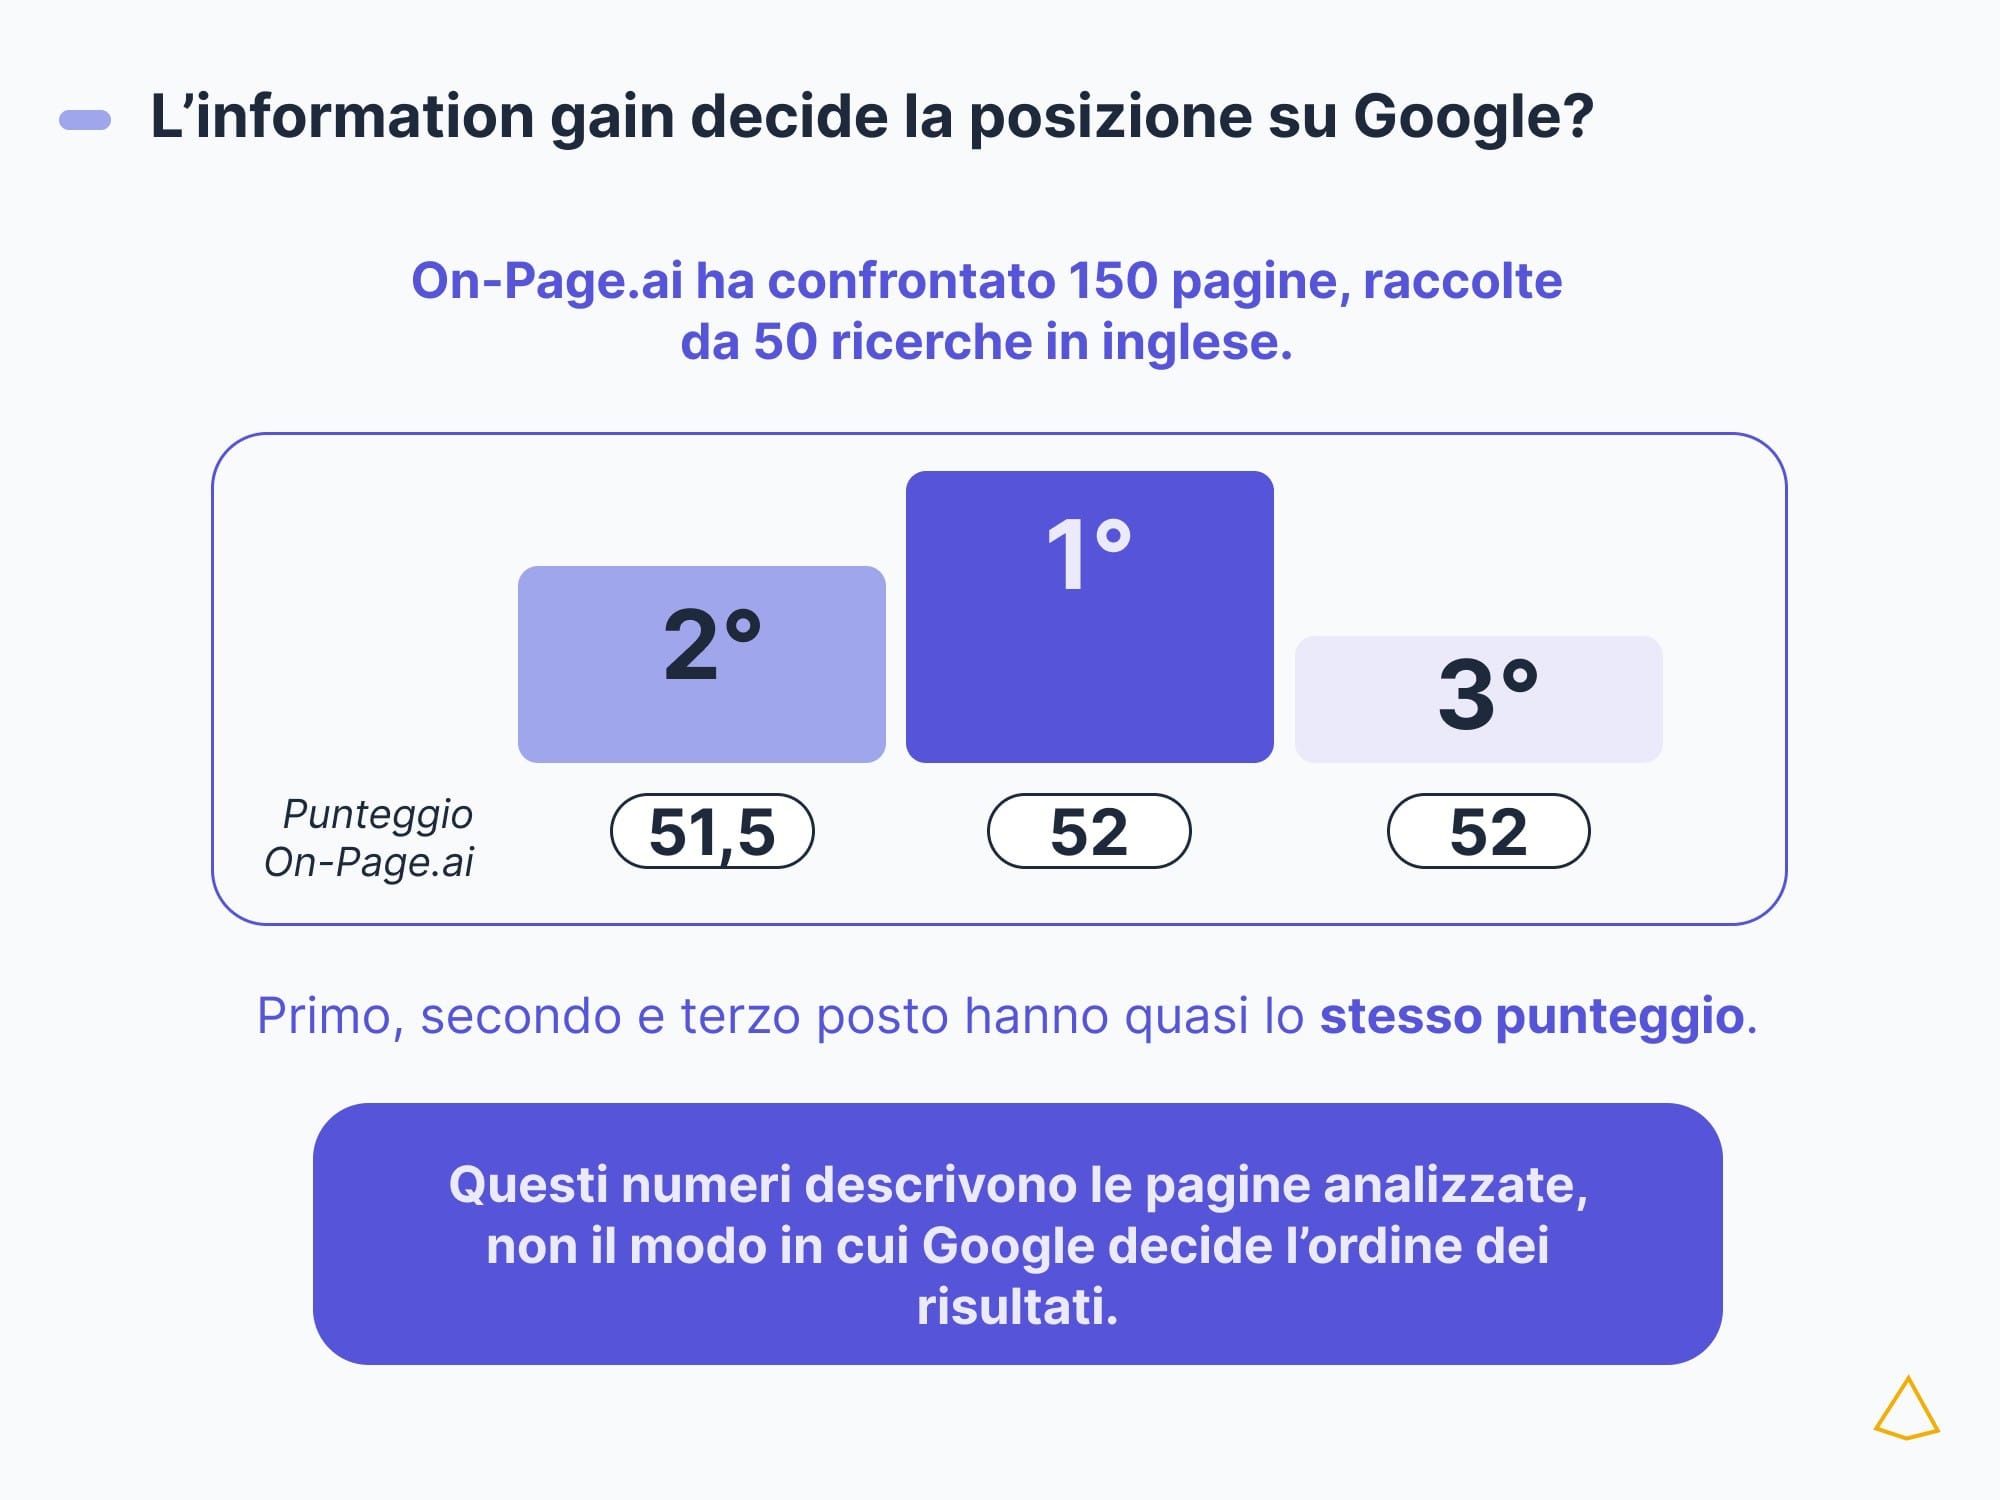
Punteggi quasi identici ai primi tre posti non spiegano l’ordine dei risultati
Che cos’è l’information gain score?
L’information gain score è la rappresentazione numerica del contributo atteso da un documento rispetto alle informazioni già ricevute dall’utente sullo stesso tema.
La stima cambia insieme al percorso: ogni nuova pagina consultata modifica il termine di confronto.
Nel brevetto la scala 0-1 serve come esempio. Lo zero corrisponde a un documento completamente ridondante rispetto al materiale precedente; l’uno, a un testo composto interamente da informazioni assenti nelle risorse già viste. I valori intermedi descrivono le gradazioni fra questi estremi.
Si può misurare l’information gain di un contenuto?
Si può stimare, scegliendo anzitutto un termine di confronto.
Ogni strumento scatta una fotografia da un’angolazione: una query, una SERP o un gruppo di pagine osservato in un certo momento.
Cambiando l’inquadratura, cambia anche il risultato.
On-Page.ai, per esempio, confronta il testo principale di una pagina con gli altri risultati della stessa ricerca ragionando per significato: due parafrasi contano come sovrapposizione.
Il suo punteggio 0-100 risponde a una domanda: quanto appare semanticamente distinta questa pagina dal gruppo analizzato?
Le suite più diffuse osservano qualità vicine, ciascuna con una lente diversa.
SEOZoom ricava dai risultati in Top 20 un brief su argomenti ricorrenti e copertura mancante. Ahrefs confronta i temi trattati con le pagine meglio posizionate. Semrush valuta SEO, leggibilità e tono; la voce “Originalità” corrisponde al controllo antiplagio. Similarweb monitora prompt, menzioni, fonti citate e traffico proveniente dai motori AI.
Sono strumenti diversi perché rispondono a domande diverse. Offrono fotografie utili di copertura, distanza semantica o visibilità; il brevetto immagina invece anche il film personale delle informazioni ricevute dall’utente, scena dopo scena.
Information gain e commodity content
Nella guida di Google, il commodity content richiama il significato di commodity: informazioni basate soprattutto su conoscenze comuni, facili da reperire e riproducibili da autori diversi.
L’ennesima guida con “sette consigli” può essere corretta, ordinata e aggiornata. Il tratto decisivo è l’intercambiabilità: sostituirla con una risorsa equivalente cambia poco ciò che il lettore porta con sé.
Il valore distintivo può nascere da nuove evidenze: dati, misurazioni, osservazioni, casi o esperienza documentata. Il tasso di cancellazione ricavato da mille prenotazioni, per esempio, amplia la base disponibile.
Può nascere anche da una nuova comprensione. Incrociando quei dati con la stagione e l’anticipo della prenotazione, l’analisi mostra quando il fenomeno si concentra. Anche una tesi controcorrente acquista peso quando rende visibile il passaggio dalle prove alla conclusione.
Stile del contenuto e valore informazionale
Una metafora originale può illuminare un’idea già conosciuta; un grafico costruito su una misurazione reale può documentare un fenomeno anche con una didascalia sobria.
La metafora rende più chiara la spiegazione; il grafico offre una base concreta su cui ragionare.
Anche il metodo di produzione racconta una parte della storia. Un testo interamente umano può riassumere conoscenze comuni; un contenuto assistito dall’AI può presentare dati raccolti e verificati dall’autore.
Lunghezza, aggiornamento e scelta delle parole possono migliorare l’esposizione; i numeri aiutano quando hanno origine, metodo e significato chiari. Evidenze solide e interpretazioni trasparenti danno spessore al contenuto.
Information gain, E-E-A-T e brand authority
Rilevanza, information gain, E-E-A-T e brand authority rispondono a domande diverse. La rilevanza collega pagina, query e intento: porta il lettore nella stanza giusta. L’information gain riguarda ciò che scopre una volta entrato.
L’E-E-A-T riunisce quattro dimensioni della qualità: esperienza, competenza, autorevolezza e affidabilità di chi offre quelle informazioni. La brand authority è il riconoscimento accumulato nel tempo da una fonte o da un marchio.
Per Google, l’E-E-A-T è un quadro qualitativo: i suoi aspetti emergono da una combinazione di segnali utilizzati dai sistemi di ranking.
Novità, consenso e corroborazione
Nel modello interpretativo proposto da Gianluca Fiorelli, il consenso nasce dalla convergenza di fonti autorevoli e indipendenti. L’information gain può ampliare quel quadro con un’osservazione ulteriore, mantenendo il contatto con le evidenze.
La corroborazione verifica l’osservazione attraverso dati o riscontri esterni. Una sintesi del consenso può essere affidabile, pur risultando poco distintiva; una sorpresa isolata attira l’attenzione e rimane fragile. Il contributo più solido unisce un punto di vista distintivo a prove verificabili.
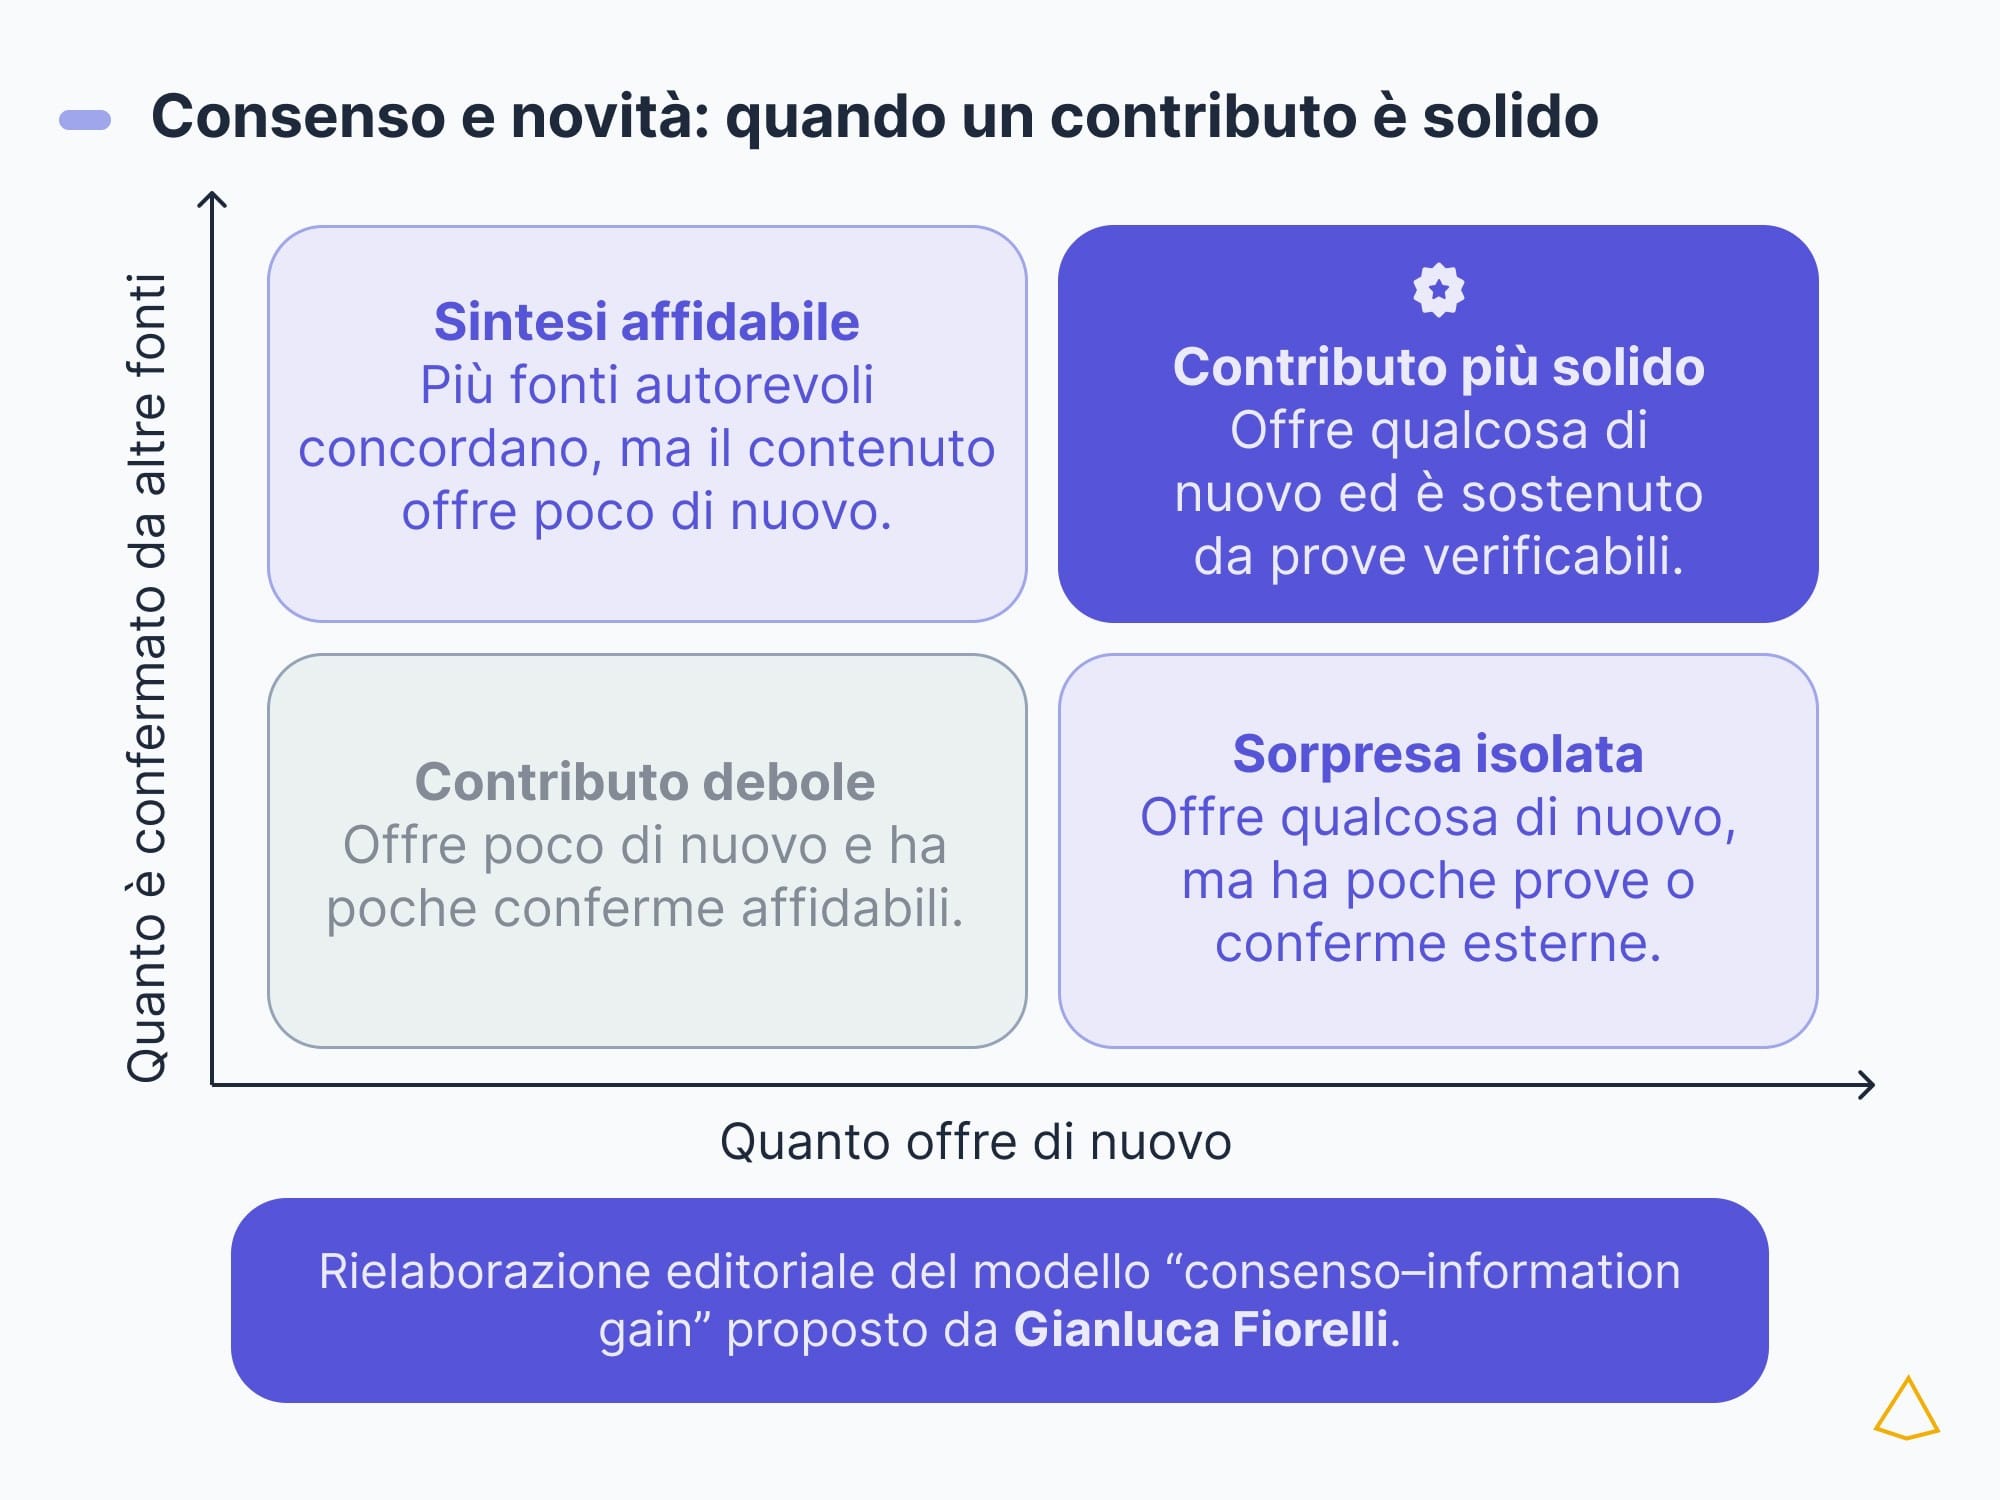
Il contributo più solido unisce qualcosa di nuovo e prove verificabili
Il rapporto con la brand authority
Un’osservazione originale può diventare riconoscibile come la firma di una fonte. Quando altri soggetti indipendenti la verificano, la citano e ne ricordano la provenienza, quel nome conquista spazio nella memoria pubblica e rafforza la propria reputazione di marca.
Novità e autorevolezza viaggiano con orologi diversi.
Un marchio noto può pubblicare spiegazioni familiari; una fonte emergente può possedere uno studio prezioso prima di aver costruito fiducia.
Metodo trasparente, prove accessibili e conferme esterne permettono alla reputazione della fonte di riflettere, nel tempo, la qualità del lavoro.
Qual è il rapporto tra information gain e GEO?
Quando consultano il web, i sistemi generativi lavorano come un redattore con più libri sul tavolo: recuperano fonti e passaggi pertinenti, poi li combinano in una risposta. Google può ampliare la domanda con il query fan-out, mentre ChatGPT Search e Perplexity interrogano il web attraverso infrastrutture proprie. Dati, confronti o interpretazioni distintive possono offrire materiale utile alla sintesi. Le documentazioni descrivono architetture diverse, senza uno information gain score condiviso.
Per le funzioni generative di Google, una pagina deve essere indicizzata e idonea a comparire nella Ricerca con uno snippet; le altre piattaforme applicano criteri tecnici e di selezione propri. Accessibilità, pertinenza, qualità della fonte e riscontri indipendenti possono quindi pesare sulla scelta. Il carattere distintivo offre una ragione in più per utilizzare la pagina; citazione, raccomandazione e visibilità dipendono dall’intero insieme.
Google raccomanda le consuete basi SEO e una struttura pensata per le persone. La guida esclude requisiti speciali come la suddivisione del testo in blocchi minimi (chunking), il markup dedicato o una riscrittura per l’AI; inoltre, non introduce una quota di novità per paragrafo.
Paragrafi e sezioni servono prima di tutto alle persone: organizzano il ragionamento e lo rendono più facile da seguire. La loro lunghezza dipende dall’idea da spiegare; su mobile, blocchi molto estesi possono rendere la lettura più faticosa.
Esempio di information gain
Immaginiamo (come caso ipotetico) dieci pagine sul costo di una campagna Google Ads. Tutte riportano gli stessi intervalli e spiegano che la spesa varia per settore, concorrenza, area geografica e budget. L’undicesima riscrive quelle indicazioni meglio e più a lungo. La lettura può risultare più chiara, ma il quadro informativo resta quasi identico.
In questo esempio, un’agenzia analizza 240 campagne gestite nel 2025 nei settori turismo, e-commerce e servizi professionali. Spiega criteri di aggregazione, esclusioni e limiti del campione. Confrontando gruppi simili per settore e budget, osserva che, quando la pagina impiega oltre tre secondi a caricarsi, ogni contatto ottenuto costa in media il 28% in più. La misurazione costituisce la nuova evidenza; il rapporto con i tempi di caricamento è l’interpretazione sostenuta dai dati.
